Когда у проекта появляется несколько сервисов, HTTPS, пики трафика и необходимость не светить внутренние адреса, прямой доступ к приложению быстро становится неудобным. В такой схеме реверс-прокси берет на себя внешнюю точку входа: принимает запросы, решает, куда их отправить, и помогает навести порядок между клиентом и бэкендом.
Что такое реверс-прокси простыми словами
Реверс-прокси — это сервер или программный слой, который стоит перед вашим сайтом, API или другим внутренним сервисом. Пользователь обращается к публичному домену или IP-адресу, а запрос сначала попадает на reverse proxy, и только потом — на один из внутренних серверов.
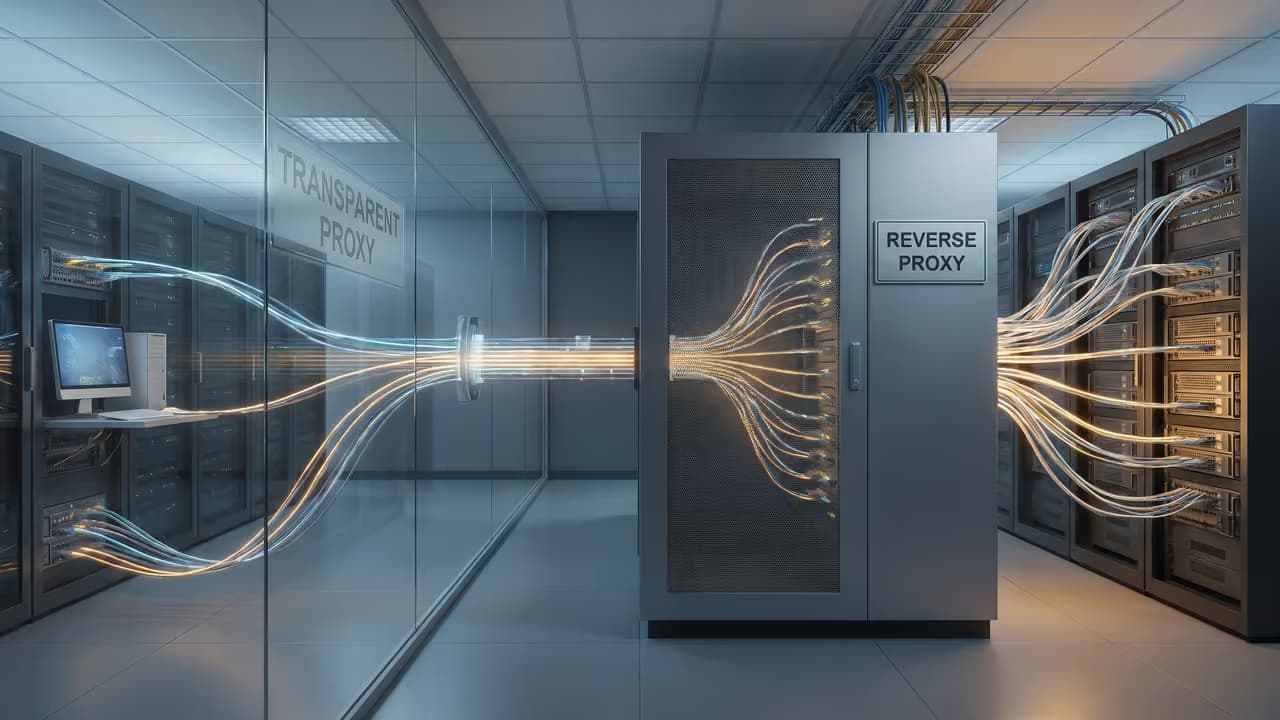
Ключевая мысль простая: обычный прокси чаще работает на стороне клиента и помогает исходящим подключениям, а реверс-прокси работает на стороне сервера и управляет входящим трафиком. Он скрывает origin, завершает TLS, распределяет нагрузку, может кешировать ответы и применять правила доступа.
Если коротко: реверс-прокси нужен не для смены вашего IP в браузере или парсере, а для публикации и защиты собственных сервисов с одной управляемой точки входа.
Где он стоит в сетевой схеме
В типовой схеме есть клиент, публичная точка входа и внутренние серверы. Клиент видит только домен проекта и подключается к reverse proxy. Внутренние узлы — приложение, API, медиа-сервер, админка, статика — могут находиться в приватной сети и не принимать прямые подключения извне.
По этой причине реверс-прокси часто используют там, где нужно публиковать несколько сервисов через один внешний адрес. Например, один и тот же домен может отдавать лендинг, API и панель управления, но физически это будут разные upstream-серверы.
Мобильные прокси России от 590 ₽ с ротацией
Отслеживайте, меняйте, переключайте и группируйте прокси в одном месте.
Перейти в личный кабинетКак работает реверс-прокси
Технически это посредник между клиентом и приложением. Чаще всего reverse proxy работает с HTTP и HTTPS на уровне приложения, но многие реализации умеют и TCP-сценарии. Конкретные возможности зависят от программного продукта и конфигурации.
Клиент открывает соединение с публичным адресом и отправляет запрос на домен проекта.
Реверс-прокси принимает соединение, при необходимости завершает TLS и читает параметры запроса: host, путь, метод, заголовки, иногда SNI или другие метаданные.
По правилам маршрутизации он выбирает нужный upstream. Это может быть один сервер, пул серверов, контейнер, внутренний API или отдельный сервис статики.
Перед отправкой запроса дальше прокси может добавить служебные заголовки, например информацию о реальном клиентском IP, исходной схеме подключения и исходном хосте.
Ответ от бэкенда возвращается через reverse proxy к клиенту. По пути его можно сжать, отдать из кеша, залогировать, ограничить по размеру или отклонить по политике безопасности.
Если используется HTTPS, важно понимать границу шифрования. Когда TLS завершается на реверс-прокси, именно он видит расшифрованный HTTP-трафик. Дальше до бэкенда данные могут идти как в открытом виде внутри защищенного сегмента сети, так и повторно шифроваться — это зависит от архитектуры и требований безопасности.
Какие задачи он решает на практике
Единая точка входа для нескольких сервисов
Самый частый сценарий — собрать несколько внутренних приложений за одним внешним адресом. По домену, пути или заголовкам reverse proxy направляет запросы в разные места: /api — на API, /static — на статику, отдельный поддомен — на админку.
Для команды это удобно: сертификаты, логирование, маршрутизация и базовые правила доступа живут в одном месте. Для пользователя все выглядит как единый сервис.
Балансировка нагрузки
Если приложение развернуто на нескольких узлах, реверс-прокси может распределять запросы между ними. Это снижает нагрузку на один сервер и упрощает масштабирование. В зависимости от реализации используются разные алгоритмы: round robin, least connections, weighted routing и другие.
На практике это особенно полезно для проектов с неравномерным трафиком: рекламные кампании, сезонные всплески, API с пиковыми окнами, медийные страницы с резкими заходами после рассылки или публикации.
TLS-терминация и управление сертификатами
Когда HTTPS завершается на reverse proxy, не нужно настраивать сертификаты отдельно на каждом бэкенде. Это упрощает продление, замену и контроль версий протокола. Плюс можно централизованно настроить редиректы с HTTP на HTTPS и базовые security-заголовки.
Но есть и оборотная сторона: если приложение рассчитывает видеть исходную схему подключения, ему нужно корректно передавать X-Forwarded-Proto или аналогичный признак. Иначе возникают циклические редиректы, неправильные абсолютные ссылки и проблемы с cookie.
Кеширование и ускорение отдачи
Обратный прокси может кешировать часть ответов и снижать нагрузку на бэкенд. Это особенно заметно на статике, документации, изображениях, типовых JSON-ответах без персонализации и публичных страницах с предсказуемым содержимым.
Но кеш — не магия. Если правила заданы небрежно, можно отдать пользователю устаревшую страницу, смешать персональные данные между сессиями или сломать обновление контента. Кешировать стоит только то, для чего понятны TTL, ключи кеша и влияние заголовков Cache-Control, Vary и cookie.
Скрытие origin и первичная фильтрация трафика
Reverse proxy позволяет не выставлять внутренние IP-адреса и порты наружу. Снаружи виден только внешний слой, а прямой доступ к приложению можно ограничить на уровне сети. Это не делает инфраструктуру неуязвимой, но уменьшает площадь атаки и упрощает контроль трафика.
Здесь же обычно настраивают rate limiting, ограничения по размеру тела запроса, базовую фильтрацию методов, списки доверенных сетей и интеграцию с WAF. Для форм обратной связи, публичных API и служебных панелей это часто дает больше пользы, чем попытка защищать каждый сервис отдельно.
Единое логирование и наблюдаемость
Когда весь входящий трафик проходит через одну точку, проще собирать логи, считать коды ответов, время ответа upstream, число активных соединений и распределение ошибок 502/504. Это сильно помогает в диагностике: сразу видно, проблема в приложении, сети, TLS или самом прокси.
Для команды продвижения и продукта это тоже полезно. Например, можно быстро понять, что у промостраницы выросла доля 5xx после запуска кампании, а не искать причину по фрагментам логов на разных узлах.
Чем реверс-прокси отличается от других сетевых ролей
| Инструмент | На чьей стороне стоит | Что скрывает | Основная задача |
|---|---|---|---|
| Прямой прокси | На стороне клиента | Клиента и его выход в сеть | Управлять исходящими подключениями приложений и пользователей |
| Реверс-прокси | На стороне сервера | Origin и внутреннюю схему сервисов | Принимать входящие запросы и направлять их к нужному upstream |
| Балансировщик нагрузки | На стороне сервера | Не обязательно что-то скрывает | Распределять трафик между несколькими узлами |
| NAT | На сетевом шлюзе | Только адресацию | Транслировать адреса, а не анализировать HTTP-логику |
| CDN | На внешней распределенной сети | Частично origin | Доставлять и кешировать публичный контент ближе к пользователю |
Границы между этими ролями не всегда жесткие. Многие reverse proxy умеют балансировку нагрузки, а некоторые решения на практике совмещают функции обратного прокси, шлюза приложений и CDN-логики. Но для архитектуры полезно разделять роли по задаче, а не по маркетинговому названию продукта.
Какие настройки чаще всего решают исход
Передача реального IP клиента
Если приложение получает запросы только от reverse proxy, без специальных заголовков оно будет видеть IP самого прокси, а не пользователя. Для логов, rate limiting, антифрода, аналитики и геозависимой логики это критично.
Обычно используют X-Forwarded-For, X-Forwarded-Proto, X-Forwarded-Host или стандартизованный заголовок Forwarded. Но приложение должно доверять этим данным только от известного списка proxy-узлов.
Типичная ошибка — читать
X-Forwarded-Forот любого клиента из интернета. В таком случае реальный IP легко подменяется, а логи и лимиты перестают что-либо значить.
Host, схема и редиректы
Многие приложения строят абсолютные URL, ставят secure-cookie и делают редиректы, ориентируясь на заголовок Host и схему подключения. Если reverse proxy не передал эти значения корректно, появляются странные симптомы: редирект с HTTPS обратно на HTTP, неверный домен в письмах, смешанный контент, ошибки callback-URL.
Особенно это заметно в CRM, CMS, системах оплаты, SSO и API-документации, где абсолютные ссылки используются постоянно.
Таймауты, буферы, размер тела запроса, WebSocket
По умолчанию прокси нередко настроен консервативно. Для больших загрузок, длинных запросов, SSE, gRPC или WebSocket этого может не хватить. В итоге фронт видит 502, 504, оборванные соединения или зависания на длинных операциях.
Если у вас загрузка каталогов, генерация отчетов, потоковые ответы или постоянные соединения, параметры таймаутов и буферизации нужно проверять отдельно. Универсального значения здесь нет: оно зависит от приложения и профиля нагрузки.
Проверки доступности и sticky sessions
Когда upstream-серверов несколько, reverse proxy должен понимать, какой из них жив, а какой уже нет. Для этого нужны health checks: пассивные или активные, в зависимости от реализации. Без них часть запросов будет продолжать ходить в неработающий узел.
Если приложение хранит состояние сессии локально, может понадобиться sticky session — закрепление клиента за конкретным сервером. Это рабочий, но не самый элегантный костыль. В долгую лучше выносить состояние в общее хранилище, иначе масштабирование будет ограниченным.
Правила кеша и сжатие
Сжатие и кеш дают хороший эффект, только если применяются адресно. Для изображений, CSS, JS, документации и публичных ответов это почти всегда полезно. Для страниц с авторизацией, корзиной, кабинетами и персонализированным HTML — наоборот, легко получить неприятные побочные эффекты.
Минимум, который стоит проверить: какие ответы кешируются, по каким ключам, учитываются ли cookie, заголовки Vary и метод запроса.
Плюсы и ограничения без рекламной мишуры
| Что дает | Что важно помнить |
|---|---|
| Одна управляемая точка входа | Сам reverse proxy тоже становится критичным узлом и требует резервирования |
| Скрытие внутренних адресов и сервисов | Это не равно полной защите; origin нужно закрывать и на уровне сети |
| TLS-терминация и централизованные сертификаты | Прокси видит расшифрованный трафик, значит, к нему выше требования доверия и безопасности |
| Балансировка и масштабирование | Без health checks и нормальной схемы сессий можно получить нестабильную работу |
| Кеширование и снижение нагрузки | Неправильный кеш ломает персонализацию и актуальность данных |
| Единые логи и метрики | Если не настроен real client IP, аналитика и антифрод будут искажены |
Отдельно стоит учитывать влияние на производительность. Формально reverse proxy добавляет еще один сетевой хоп. Но на практике общая скорость сервиса нередко улучшается за счет keep-alive, кеша, сжатия и разгрузки приложения от TLS. Результат зависит от конфигурации, нагрузки и типа контента.
Ошибки, которые встречаются чаще всего
Приложение видит IP прокси вместо IP клиента, а команда замечает это только после проблем с логами, лимитами и аналитикой.
HTTPS завершается на reverse proxy, но приложение думает, что работает по HTTP, и начинает делать лишние редиректы.
Origin-сервер остается доступным напрямую из интернета, хотя весь смысл схемы был в том, чтобы спрятать его за внешним слоем.
Включают кеширование «на все подряд» и получают устаревшие страницы, чужие данные в ответах или сломанную авторизацию.
Не учитывают WebSocket, long polling, SSE или большие загрузки и ловят 502/504 под реальной нагрузкой.
Ставят один reverse proxy без резервирования, а потом превращают его в единую точку отказа.
Смотрят только на общую доступность, но не контролируют метрики upstream: connect time, response time, коды 5xx, длину очередей соединений.
Когда нужен не реверс-прокси, а другой тип прокси
Для аудитории SEO, рекламы и автоматизации это важное различие. Если задача — проверить выдачу из разных сетей, разнести исходящие подключения по IP, протестировать сайт как внешний пользователь или работать с несколькими браузерными профилями, reverse proxy тут не поможет.
В таких сценариях смотрят в сторону клиентских решений: SOCKS5-прокси, прокси с ротацией и связки с браузерной изоляцией, например через антидетект-браузер. Это другой слой задачи: не публикация собственного сервиса, а организация исходящего трафика приложений.
Проще говоря, реверс-прокси отвечает на вопрос «как безопасно и удобно принять входящий трафик к моему сервису», а обычный прокси — на вопрос «как мое приложение будет выходить в сеть».
Что проверить перед запуском
- Понимаете ли вы, где заканчивается TLS и нужен ли повторный HTTPS до бэкенда.
- Передаются ли корректно real client IP, host и схема подключения.
- Закрыт ли origin от прямого внешнего доступа, если он не должен быть публичным.
- Настроены ли health checks и логика вывода узла из ротации при ошибках.
- Подходят ли таймауты, размер body, keep-alive и буферизация под ваш реальный трафик.
- Проверены ли WebSocket, SSE, gRPC или другие долгоживущие соединения, если вы их используете.
- Понимаете ли вы, что именно кешируется и не попадут ли туда персональные ответы.
- Собираются ли метрики 4xx/5xx, время ответа upstream и логи с привязкой к реальному IP.
- Есть ли резервирование reverse proxy, если он становится единой точкой входа для бизнеса.
Что из этого следует
Реверс-прокси — это рабочий серверный инструмент для входящего трафика. Он полезен, когда нужно собрать несколько сервисов за одной точкой входа, спрятать origin, централизовать TLS, добавить балансировку, кеш и управляемые правила доступа.
Но путаница начинается там, где его пытаются воспринимать как универсальный «прокси вообще». Для исходящих задач, браузеров, парсеров и внешних проверок нужны другие инструменты. А для server-side-схемы главный критерий не само слово reverse proxy, а то, насколько аккуратно вы настроили headers, таймауты, кеш, доступ к origin и наблюдаемость.
Частые вопросы по теме
Реверс-прокси и обратный прокси — это одно и то же?
Да. В русскоязычной практике используют оба варианта: «реверс-прокси» и «обратный прокси». Речь идет об одном и том же серверном слое перед приложением, который принимает входящие запросы и отправляет их на внутренние сервисы по заданным правилам.
Может ли реверс-прокси заменить балансировщик нагрузки?
Во многих сценариях — да, потому что reverse proxy часто умеет распределять трафик между несколькими upstream-серверами. Но это зависит от конкретной реализации. Кроме того, балансировка — только одна из его функций. Отдельные решения уровня L4 и L7 могут отличаться по производительности, алгоритмам и глубине проверки узлов.
Шифрует ли реверс-прокси трафик?
Он может принимать HTTPS и завершать TLS на своей стороне. Это значит, что между клиентом и публичной точкой входа соединение зашифровано. Дальше до бэкенда трафик может идти как по HTTP внутри доверенной сети, так и по повторно зашифрованному HTTPS. Конкретная схема выбирается по требованиям безопасности.
Видит ли приложение реальный IP пользователя за реверс-прокси?
По умолчанию не всегда. Без специальных заголовков бэкенд часто видит IP самого proxy-узла. Чтобы приложение получало адрес клиента, нужно корректно настроить передачу и доверие к X-Forwarded-For или Forwarded. Иначе логи, rate limiting и аналитика будут неточными.
Нужен ли реверс-прокси маленькому сайту на одном сервере?
Не всегда, но часто он полезен даже на небольшом проекте. Если нужно централизовать HTTPS, удобно вести логи, разруливать несколько сервисов на одном домене или подготовить площадку к масштабированию, reverse proxy быстро окупается по удобству администрирования. Если сайт совсем простой, схема может быть избыточной.
Подходит ли реверс-прокси для SEO-мониторинга, парсинга и проверки рекламы?
Только если речь о защите и публикации вашего собственного сервиса, который обслуживает такие задачи. Для исходящих проверок позиций, рекламной выдачи, доступности страниц из разных сетей и автоматизации обычно используют не reverse proxy, а клиентские прокси и отдельные браузерные профили.
Чем reverse proxy отличается от CDN?
CDN — это распределенная сеть доставки контента, обычно с множеством внешних узлов ближе к пользователям. Реверс-прокси — это роль сервера перед вашим приложением. На практике CDN может включать функции reverse proxy, но их цели разные: CDN в первую очередь ускоряет доставку и кеширование, а обратный прокси управляет входящим трафиком к сервису.